如果你接觸過 Jev——有時被稱為「TypeSafe AI」或「System One」風格的模型——並好奇能否像 Grok 或 Gemini 那樣把它接入 Glarity,答案是不能。Jev 並非設計為對話式大語言模型的替代品。以下說明它實際是什麼,以及這個區別為何重要。
Jev 實際做什麼
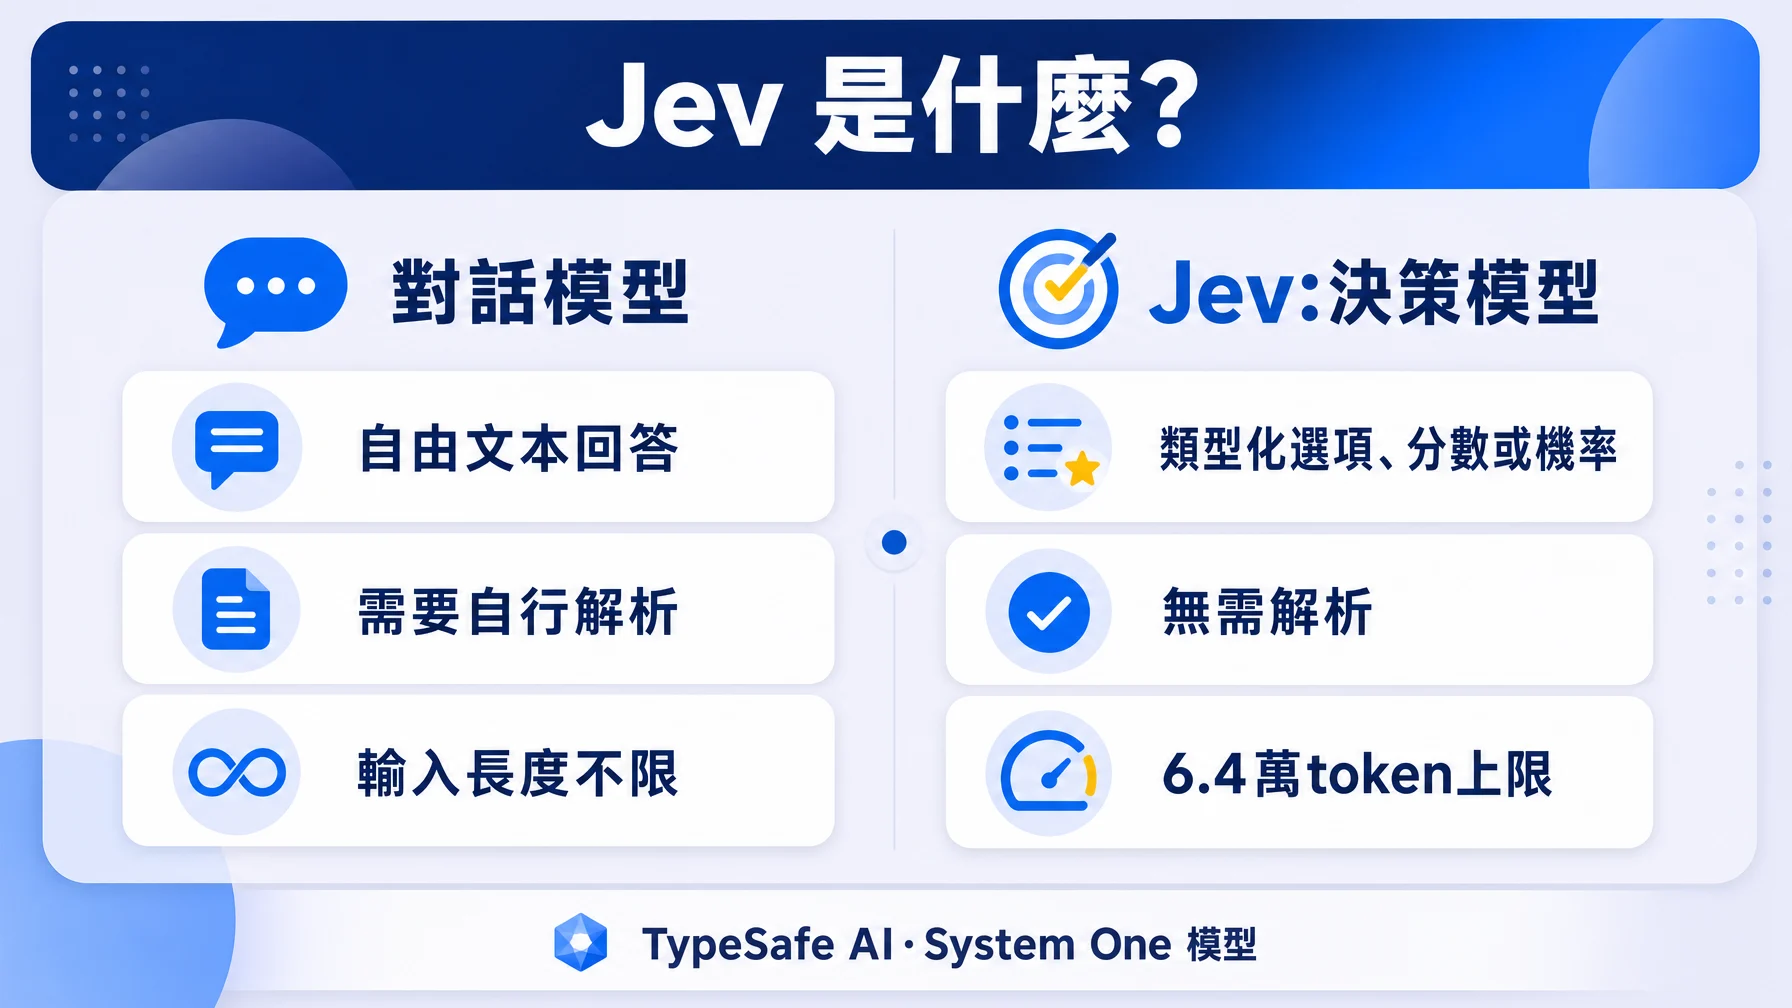
Jev 是類型化決策引擎,不是通用對話模型。它不接收自由格式的提示詞並返回自由格式的文字,而是接收結構化的狀態(state)(描述某種情境的文字)和一個問題(question),返回類型化的輸出——一個決策、一個分數或一個機率——而不是一段文字。狀態和問題合計上限為 32K token,整個交互的總預算為 64K token。它不像對話模型那樣維護多輪對話歷史;每次呼叫都是針對某個資訊快照的獨立判斷。
可以這樣理解兩者的區別:對話模型回答「這裡應該寫什麼?」Jev 回答「在這個確切情境下,決策是什麼?」——它給出的是程式碼可以直接使用的值(分數、布林值、排序後的選項),而不是需要解析的文字。
為什麼它不符合 Glarity 的自訂模型設定
Glarity 的設定 → 一般 → 連接 AI 面板圍繞一種形態構建:一個 OpenAI 相容的 /chat/completions 端點,接收系統/使用者訊息陣列並返回聊天補全結果。Glarity 透過「自訂模型」支援的所有模型——包括透過 API 金鑰接入的第三方模型——都使用這個協定。
Jev 不是這樣。它是類型化決策 API,不是聊天補全 API。它沒有「系統提示詞」或「對話」的概念可以映射到 Glarity 的翻譯、摘要或郵件回覆功能上。這些功能的運作方式是把頁面或影片內容作為聊天訊息傳送,然後取回文字回覆——這不是 Jev 的輸入輸出契約所產生的形態。即使擁有有效憑證,也沒有辦法讓 Glarity 的請求格式符合 Jev 期望接收的格式。
如果你在評估 Jev,這意味著什麼
如果你正在為某個實際場景評估 Jev——自動化審核決策、風險評分、結構化分診——值得把它當作你自己掌控的流水線中的決策支援元件,按其本身的標準去評估,而不是當作瀏覽器擴充功能的對話後端。如果你真正想要的只是一個快速、實惠的模型來驅動 Glarity 的日常翻譯和摘要,那麼透過 Glarity 自訂模型設定接入的標準聊天補全模型(Grok、Gemini 3.8 Flash 等)才是適合這項工作的工具。
常見問題
我能用 Jev 做 Glarity 的頁面摘要或翻譯嗎?不能。Jev 返回類型化的決策(分數、布林值、機率),而不是這些功能所需的自由格式文字,而且它沒有暴露供 Glarity 呼叫的聊天補全端點。
Jev 和大語言模型是同一類東西嗎?它基於類似的底層技術構建,但暴露方式不同——面向決策的狹窄、結構化輸入輸出,而非開放式文字生成。
token 上限是多少?狀態和問題合計上限為 32K token,整個交互的總預算為 64K token。
Glarity 裡該用什麼替代?任何 OpenAI 相容的對話模型都可以——具體設定方法請參考 Glarity 現有的 Grok 或 Gemini 3.8 Flash 接入教學,透過自訂模型設定連接。
Glarity 編輯部專注於 AI 搜尋、影片摘要與瀏覽器效率技巧。