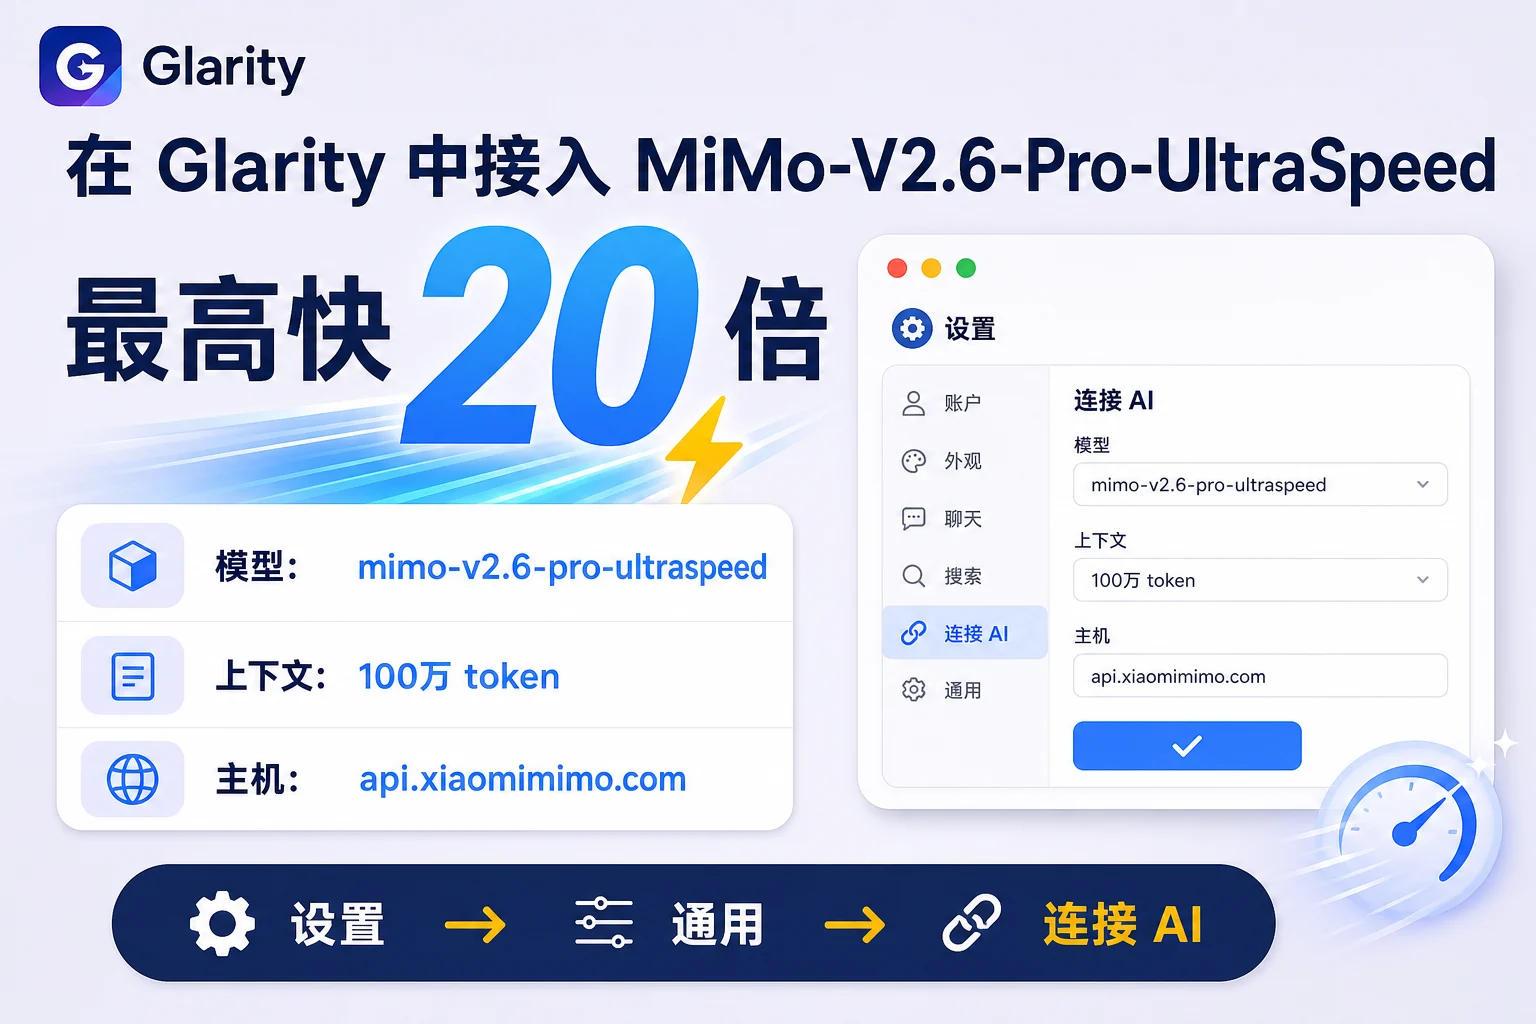
MiMo-V2.6-Pro-UltraSpeed 是 MiMo-V2.6-Pro 的高速推理模式:同样的全模态输入、100 万 token 上下文与最大 12.8 万 token 输出,但专为输出速度调优,小米官方表示相比标准版 Pro 最高可快 20 倍生成速度。Glarity 没有把 MiMo 做成内置选项,不过设置面板的"自定义模型"入口支持任何 OpenAI 兼容的 /chat/completions 端点,小米的 API 正好符合这个形态。整个配置大约五分钟,从设置 → 通用 → 连接 AI 开始。
为什么选 MiMo-V2.6-Pro-UltraSpeed
UltraSpeed 是为那些等待响应时每一秒都很重要的场景而生的——比如你正在阅读页面时同步生成总结,或者需要接近实时地生成字幕。小米表示它比标准版 Pro 最高快 20 倍(这是官方给出的上限,不是每次请求都能保证的速度,实际提速取决于具体请求)。它保留了 Pro 的全部功能——深度思考、工具调用、流式输出、网页搜索、结构化输出、上下文缓存——但代价是成本:UltraSpeed 的单价大约是标准 Pro 的 10 倍,速率限制也是按账户单独设定,而非公开的统一数值。
开始前需要准备
- 一个从小米 MiMo 控制台获取的 API 密钥
- 下面这些连接参数
Glarity 逐步配置
- 打开 Glarity 扩展,进入设置 → 通用,滚动到"连接 AI 以获得快捷的 Glarity 总结与翻译"区域。
- 将连接类型设为OpenAI API 密钥。
- 把你的小米密钥粘贴到API 密钥字段。
- 将模型设为自定义模型,填入
mimo-v2.6-pro-ultraspeed。 - 将模型上下文窗口设为最接近100 万的档位。
- 将API 主机设为
https://api.xiaomimimo.com/v1。 - 将API 路径设为
/chat/completions。 - 温度日常使用设为 0.5(想要更忠实的总结可降到 0.2),点击测试确认收到快速回复,再点击保存。
设置一览
字段 | 值 | 含义 |
|---|---|---|
连接类型 | OpenAI API 密钥 | MiMo 的 API 采用 OpenAI 对话补全格式 |
API 密钥 | 你的 MiMo 密钥 | 从 MiMo 控制台生成 |
模型 | 自定义模型 → | 官方模型 ID(注意 UltraSpeed 中的 S 是大写) |
模型上下文窗口 | 约 100 万 | 与标准 Pro 相同的输入上限 |
API 主机 |
| 来自小米官方 API 文档的基础地址 |
API 路径 |
| 标准 OpenAI 兼容路由 |
温度 | 0.5(或 0.2) | 在自然表达与忠实输出之间取平衡 |
定价
根据小米官方定价页面(2026 年 9 月 22 日更新),海外费率为每百万 token:缓存输入 $0.036、非缓存输入 $4.35、输出 $8.70——大约是标准 Pro 的 10 倍。国内费率为每百万 token ¥0.25 / ¥30 / ¥60。UltraSpeed 不提供批量计价档位。这是速度比成本更重要时才该用的模型,日常大量总结更适合用 MiMo-V2.6-Flash。
接入 UltraSpeed 后 Glarity 能做什么
能力 | 目前的表现 |
|---|---|
翻译 | 近乎实时地翻译网页文本或选中内容 |
页面总结 | 在时间敏感的阅读场景中快速生成总结 |
YouTube 总结 | 快速生成视频文字稿总结 |
视频字幕 | 更快地生成并翻译字幕,适合类实时的工作流 |
快捷邮件回复 | 近乎即时地根据选中文本生成回复 |
一键提示词 | 用 UltraSpeed 而不是默认模型运行你保存的自定义提示词 |
故障排查
- 401 / 未授权错误 —— API 密钥无效或未保存,重新粘贴后点击测试再保存。
- "未找到模型" —— 检查是否精确输入
mimo-v2.6-pro-ultraspeed(注意大写 S)。 - 费用高于预期 —— UltraSpeed 单价大约是标准 Pro 的 10 倍,时间不敏感的大量任务建议改用 Flash 或 Pro。
- 超长输入请求失败 —— 上限是输入 100 万 token / 输出 12.8 万 token。
- Glarity 仍在用旧模型 —— 只有测试成功并点击保存后设置才会生效。
常见问题
MiMo-V2.6-Pro-UltraSpeed 是 Glarity 官方支持的模型吗?不是。本教程是通过 Glarity 通用的"自定义模型"设置接入的。
它到底能快多少?小米官方表示相比标准 Pro 最高可快 20 倍生成速度。这是官方给出的上限,不是每次请求都保证的数值,实际提速会因提示词和负载不同而变化。
为什么比 Flash 或 Pro 贵这么多? UltraSpeed 用成本换取延迟:非缓存输入每百万 token $4.35、输出每百万 token $8.70,大约是标准 Pro 的 10 倍,比 Flash 高得多。只在速度真正重要时使用它,而不是日常批量总结。
相比 Pro 会不会损失功能?不会。它保留了同样的 100 万 token 上下文、多模态输入、深度思考、工具调用等功能。区别只在生成速度和价格,不在能力上。
什么时候该用 Flash 代替?如果你每天要总结很多页面,而延迟不是关键因素,MiMo-V2.6-Flash 能以 UltraSpeed 一小部分的成本提供同样的上下文窗口。
Glarity 编辑部专注于 AI 搜索、视频总结与浏览器效率技巧。
Glarity 是一款免费的浏览器扩展,支持 AI 搜索与 YouTube 视频总结,可在 glarity.app 获取。