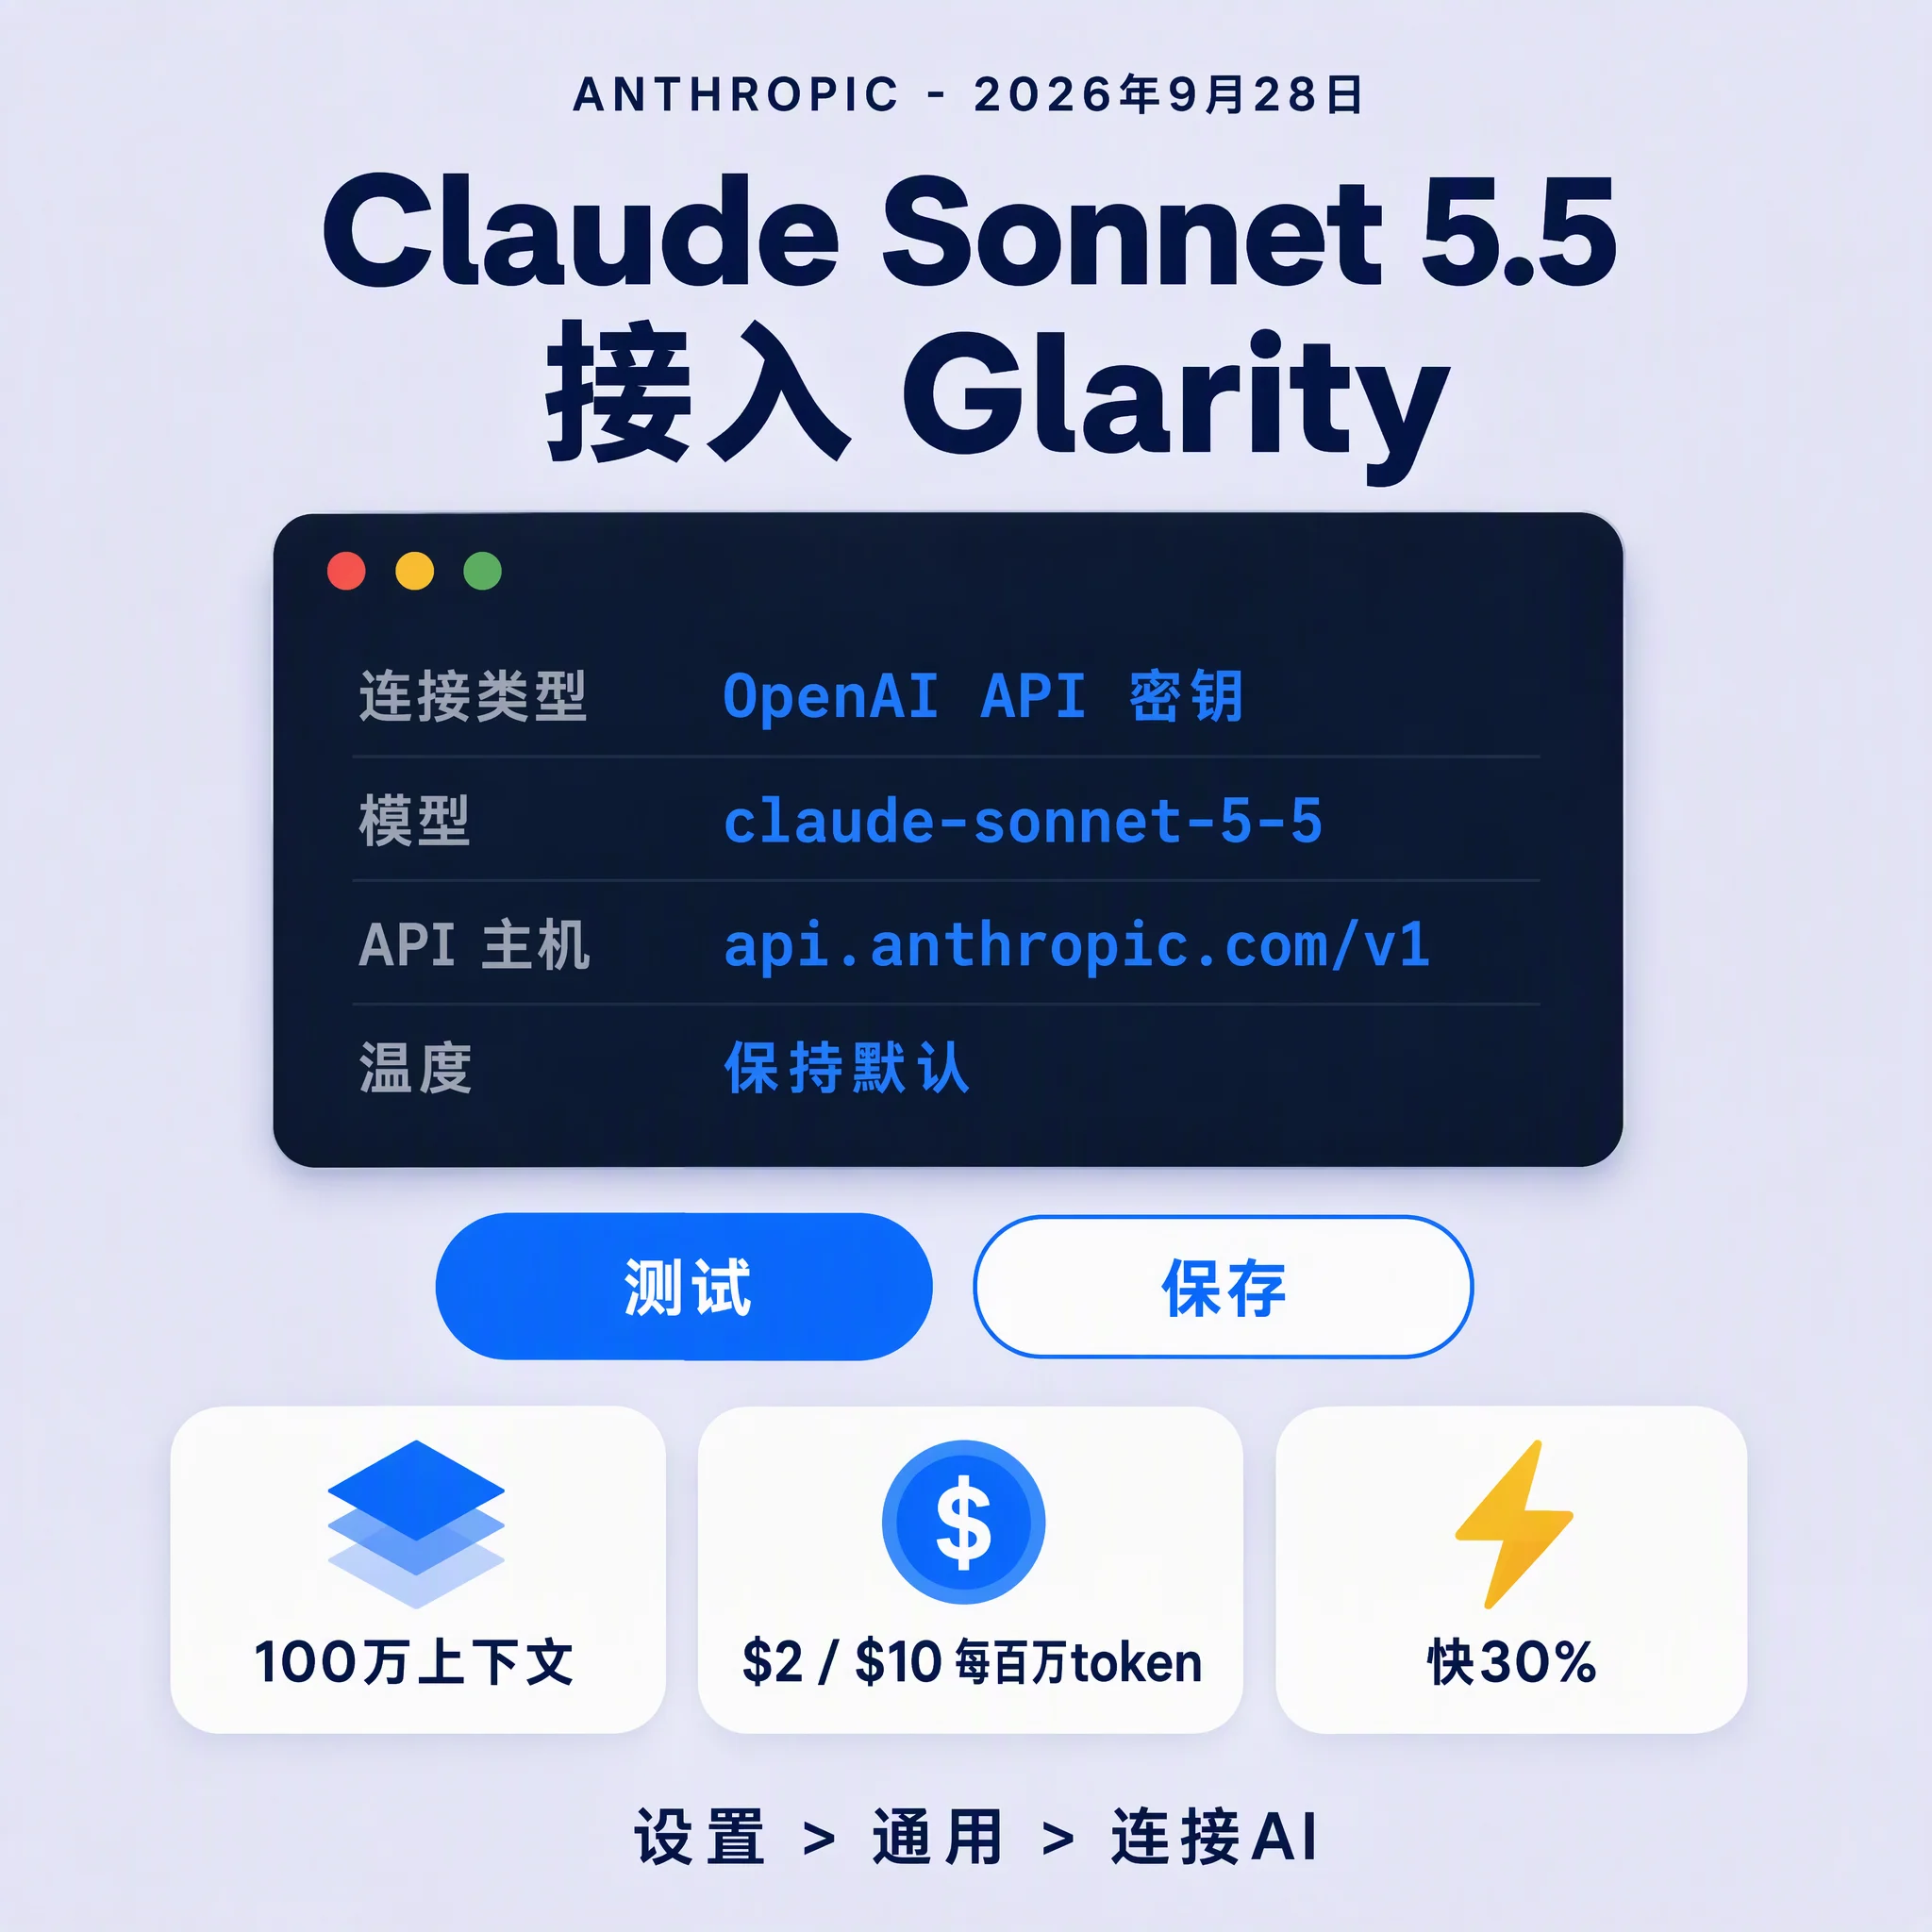
Anthropic 于 2026 年 9 月 28 日发布了 Claude Sonnet 5.5,这是其 5.5 家族的第二个模型,价格与被它取代的 Sonnet 5 完全相同——每百万输入 token 2 美元、每百万输出 token 10 美元。价格不变换来的是输出速度提升 30% 以上,并且由于达成同样答案所需的 token 更少,每个任务的成本最多降低 30%。接入 Glarity 只需四步:选择 OpenAI API 密钥(Anthropic 通过 OpenAI SDK 兼容层也能使用这一项)、粘贴 sk-ant- 密钥、在自定义模型中填入 claude-sonnet-5-5,并保持主机为 https://api.anthropic.com/v1。但有一点与本站此前的 Claude 教程已经不同,照搬旧步骤就会出错:温度这一栏请不要填写。Anthropic 的 Sonnet 5.5 模型页明确写着,非默认的 temperature 会返回错误。下文详细说明。
Claude Sonnet 5.5 规格速览
字段 | 值 |
|---|---|
模型 ID |
|
发布日期 | 2026 年 9 月 28 日——退役时间不早于 2027 年 9 月 28 日 |
上下文窗口 | 100 万 token——按当前分词器约合 55.5 万英文单词 |
最大输出 | 12.8 万 token(批处理 API 配合 beta 头可达 30 万) |
知识截止 | 2026 年 6 月 |
输入 → 输出 | 文本与图像 → 文本 |
思考 | 自适应思考默认开启,由 effort 调节(Claude API 上默认 |
定价 | 输入 $2 / 输出 $10(每百万 token);缓存写入 $2.50(5 分钟)与 $4(1 小时),缓存读取 $0.20 |
速度 | 输出比 Claude Sonnet 5 快 30% 以上,单 token 价格相同 |
以上规格来自 Anthropic 的模型页与发布公告。真正让升级成立的是公告里的数字:在 Terminal-Bench 4.0 上,Sonnet 5.5 得分 70.6%,而 Sonnet 5 为 10.3%、Claude Opus 5.5 为 66.4%;在衡量 44 个职业真实工作产出的 GDPval-AA v2.1 上得分 1844,距 Opus 5.5 的 1846 仅约两分,比 Sonnet 5 的 1449 高出约 400 分。此外还有 OSWorld 2.1 的 80.1%、Humanity's Last Exam(带工具)的 64.5%、CursorBench 4.0 的 55.5%,它也是首个仅凭截图通关《宝可梦 红》的 Sonnet 模型。需要说明的是,这些是 Anthropic 的内部评测而非第三方结论;而且 Anthropic 坦率指出,在需要持续判断的复杂开放式工作上,Opus 5.5 依然明显更强。Sonnet 5.5 用 Opus 五分之一的价格补上了大部分差距,但并没有抹平它。
为什么这个模型适合 Glarity
Glarity 每天做的事都是"阅读"类工作:总结页面、翻译页面、把一小时 YouTube 视频变成笔记、就正在看的文档提问。Sonnet 5.5 有三个特性直接对应这些场景。
- 快。 总结工具的体验取决于面板空白的时间。生成速度提升 30% 以上,区别就是"你在等摘要"还是"摘要已经在那儿了"。
- token 效率高。 Glarity 通过 OpenAI 兼容层连接 Anthropic,而该兼容层不支持提示缓存,每一轮都会重新计费全部输入。用更少的 token 得到同样的答案,在这里不是边际节省,而是整个成本结构。
- 窗口比文档大。 100 万 token 可以一次装下 300 页的书,模型同时看到开头和结尾,不必把各章笔记拼接起来。
Sonnet 5.5 还支持图像输入,这对浏览器扩展很实用:图表、扫描页、截图都能不离开当前标签页就完成翻译或解读。
相比 Sonnet 5 教程发生了什么变化
如果你已经按本站的 Claude Sonnet 5 配置教程接好了,有三处变化值得知道,其中只有第一处直接影响 Glarity 用户。
一、非默认的采样参数现在会报错。 Anthropic 的 Sonnet 5.5 模型页在"Good to know"中写明:把 temperature、top_p 或 top_k 设为非默认值会返回错误。这推翻了本站此前所有 Claude 教程的建议——把温度设为 0.5,严格直译时设为 0.2。在 Sonnet 5.5 上,温度一栏保持默认。如果你已有可用的 Sonnet 5 配置,只改模型 ID 才是正确做法;既改模型 ID 又重新填入 0.5,就会撞上一屏报错。
二、关闭思考的写法变了。 Sonnet 5 可以发送 thinking: disabled,而 Sonnet 5.5 会报错并指向 between_tools。通过 Glarity 你永远不会发送这两个参数——扩展没有暴露思考设置——所以这只对自行维护 Claude 集成的人有意义。经由 Glarity,自适应思考以默认的 high effort 运行,无需任何配置。
三、Sonnet 首次引入安全层。 Sonnet 5.5 是首个搭载与 Opus 级别相当的网络安全防护与回退机制的 Sonnet,也是首个带推理抽取防护分类器的 Sonnet。实际影响是:可能助长网络攻击的请求会被拒绝,而 Anthropic 的服务端回退会把这类请求改用 Claude Sonnet 5 重试。对总结用途而言这基本无感,但如果你用 Glarity 处理安全研究或攻击工具类材料,可能会在旧 Claude 模型会直接作答的地方遇到偏 Sonnet 5 的回答或直接拒绝。
四步完成接入
打开 Glarity,进入设置 → 通用,滚动到"连接 AI 以获得快捷的 Glarity 总结与翻译"。
- 选择"OpenAI API 密钥"。Anthropic 提供了接受 OpenAI 格式请求的 OpenAI SDK 兼容层,因此这一项对 Anthropic 同样适用。
- 把 Anthropic API 密钥粘贴到 API 密钥字段。密钥以
sk-ant-开头,在 Claude Console 生成。OpenAI 的密钥在这里不管用。 - 模型选择自定义模型,准确填入
claude-sonnet-5-5。如果下拉列表里已经出现 Claude Sonnet 5.5,直接选它也行——无论哪种方式,ID 才是准绳。 - 温度保持默认,点击测试,再点击保存。
有两个字段保持默认值,但请确认一次。API 主机为 https://api.anthropic.com/v1——Anthropic 兼容层快速开始里给出的基础地址;API 路径为 /chat/completions。如果此前的配置残留了别家的主机,请改回来,这也是测试报连接错误而非模型错误时的解决办法。模型上下文窗口选择最大的档位,100 万 token 的模型上限才是真实边界,档位只是安全阀。
一次会话的真实成本
每百万输入 token 2 美元,意味着单 token 价格是 Claude Fable 5.1 的五分之一。下表沿用我们为 Fable 5.1 做过的会话表,按 Sonnet 5.5 的费率计算——均为估算,实际 token 数会随语言和页面复杂度变化。
你喂给它的内容 | 输入 token | 输出 token | 约合成本 |
|---|---|---|---|
1 小时 YouTube 视频 → 总结 | 约 12,000 | 约 800 | 约 $0.03 |
30 页报告 → 总结 + 对话 | 约 40,000 | 约 1,500 | 约 $0.10 |
300 页图书 → 全书总结 | 约 230,000 | 约 3,000 | 约 $0.49 |
大型调研资料(输入约 50 万) | 约 500,000 | 约 8,000 | 约 $1.08 |
同样资料改用 Claude Fable 5.1 | 约 500,000 | 约 8,000 | 约 $5.40 |
这张表有两个读法。第一,日常那几行几乎是零头——一条视频总结三分钱,用这个模型重度阅读一周,花费还不如一个三明治。第二,Sonnet 5.5 与 Sonnet 5 的差价根本不在这张表里:两者公布的费率相同。差距在于 Sonnet 5.5 用更少的 token 完成同一任务(Anthropic 称最多减少 30%),而既然兼容层每一轮都重新计费全部输入,这份效率就直接等于你的支出。
需要注意的地方与 Fable 5.1 教程相同:兼容层不支持提示缓存。宣传中的 $0.20 缓存读取价只适用于使用 Anthropic 原生 API 的应用。经由 Glarity,围绕一本 23 万 token 的书展开的多轮对话,每一轮追问都会重新计费整本书。把想问的一次性写进一个完整请求,$0.49 才会停在一个"单次"的数字上。
什么时候用,什么时候跳过
把它当作你的默认 Claude 通道。这是一次罕见的、没有取舍的升级:与 Sonnet 5 同价,更快,每任务 token 更少,并且 Anthropic 公布的所有评测都更好。如果你现在连接的是 claude-sonnet-5,把那个字段改成 claude-sonnet-5-5,是这篇文章里性价比最高的五秒钟。
在以下场景积极使用:长文档、数小时的文字稿、必须保住语气与术语的翻译,以及任何你原本会打印出来阅读的会话。
在两种情况下跳过。如果只是短而随意的使用——读几段、扫一眼页面——Flash 级模型便宜得多,质量差异你也感觉不到。另外,把 Claude Fable 5.1 留给真正需要持续判断的开放式工作:它每百万 token 为 $10 / $50,价格是五倍,而 Anthropic 自身的建议是只有在更便宜模型的产出不够时才上一档。对 Glarity 的绝大多数用途来说,这条线现在正落在 Sonnet 5.5 上。
在 Claude 模型之间切换只需改一个字段——Glarity 的"连接 AI"同一时间只运行一套配置,所以从 Sonnet 5.5 换到 Fable 5.1,只需改模型名。
出错时怎么办
现象 | 可能原因 | 处理 |
|---|---|---|
设置温度后测试立刻返回 400 | Sonnet 5.5 拒绝非默认的采样参数 | 把温度字段清回默认值,重新测试 |
测试返回 401 | 密钥错误,或填入了 OpenAI 密钥 | 在 Claude Console 生成密钥(以 |
提示"找不到模型" | 输入的 ID 不准确 | 填入 |
529 或"Overloaded" | Anthropic 自身的过载错误 | 稍等后重试,兼容层会原样透传 Anthropic 的状态码 |
测试报连接错误 | 此前配置残留了其他主机 | 把 API 主机设为 |
429 或触发速率限制 | 密钥所在层级的 RPM/TPM 上限 | 稍等,并在 Console 申请提额 |
长请求被拒绝 | 超出 100 万 token 窗口 | 拆分文档;100 万 token 按当前分词器约合 55.5 万英文单词 |
常见问题
Claude Sonnet 5.5 免费吗?不免费,每次调用都按 token 计费。Anthropic 的定价 FAQ 提到新账号会获得少量用于测试的免费额度,最多够跑几次。请按你实际阅读量做预算——在这个模型上,这笔预算很小。
为什么有些模型列表把它写成 `anthropic/claude-sonnet-5.5`?那是模型目录使用的带厂商前缀的显示名。Claude API 本身接受的 ID 是 claude-sonnet-5-5,没有斜杠也没有点号。请把它填进自定义模型。
我对 Claude Sonnet 5 已经满意,还需要换吗?需要。价格完全相同,输出更快,而且 token 效率让同样的会话更便宜。没有哪种情形是留在 Sonnet 5 更省钱的——这并不是模型升级常见的形态,值得用上。
安全相关的总结会被拒绝吗?有可能。Sonnet 5.5 是首个带前沿级网络安全防护的 Sonnet,可能助长网络攻击的请求会被拒绝,或经 Anthropic 的服务端回退改用 Claude Sonnet 5。常规的安全阅读——公告、事件报告、政策文件——不受影响。
这会取代我的 Fable 5.1 配置吗?大多数会话里会。Fable 5.1 是更高一档,请保留两套凭据,在确实需要 Sonnet 5.5 给不出的持续判断时改一下模型字段即可切换。
翻译时温度应该设成多少?保持 Glarity 的默认值。此前 Claude 教程里的 0.2 早于 Sonnet 5.5 的参数变更,很可能在测试这一步就失败。
Glarity 编辑部专注于 AI 搜索、视频总结与浏览器效率技巧。
Glarity 是一款免费的浏览器扩展,支持 AI 搜索与 YouTube 视频总结,可在 glarity.app 获取。