如果你接触过 Jev——有时被称为"TypeSafe AI"或"System One"风格的模型——并好奇能否像 Grok 或 Gemini 那样把它接入 Glarity,答案是不能。Jev 并非设计为对话式大语言模型的替代品。以下解释它实际是什么,以及这个区别为何重要。
Jev 实际做什么
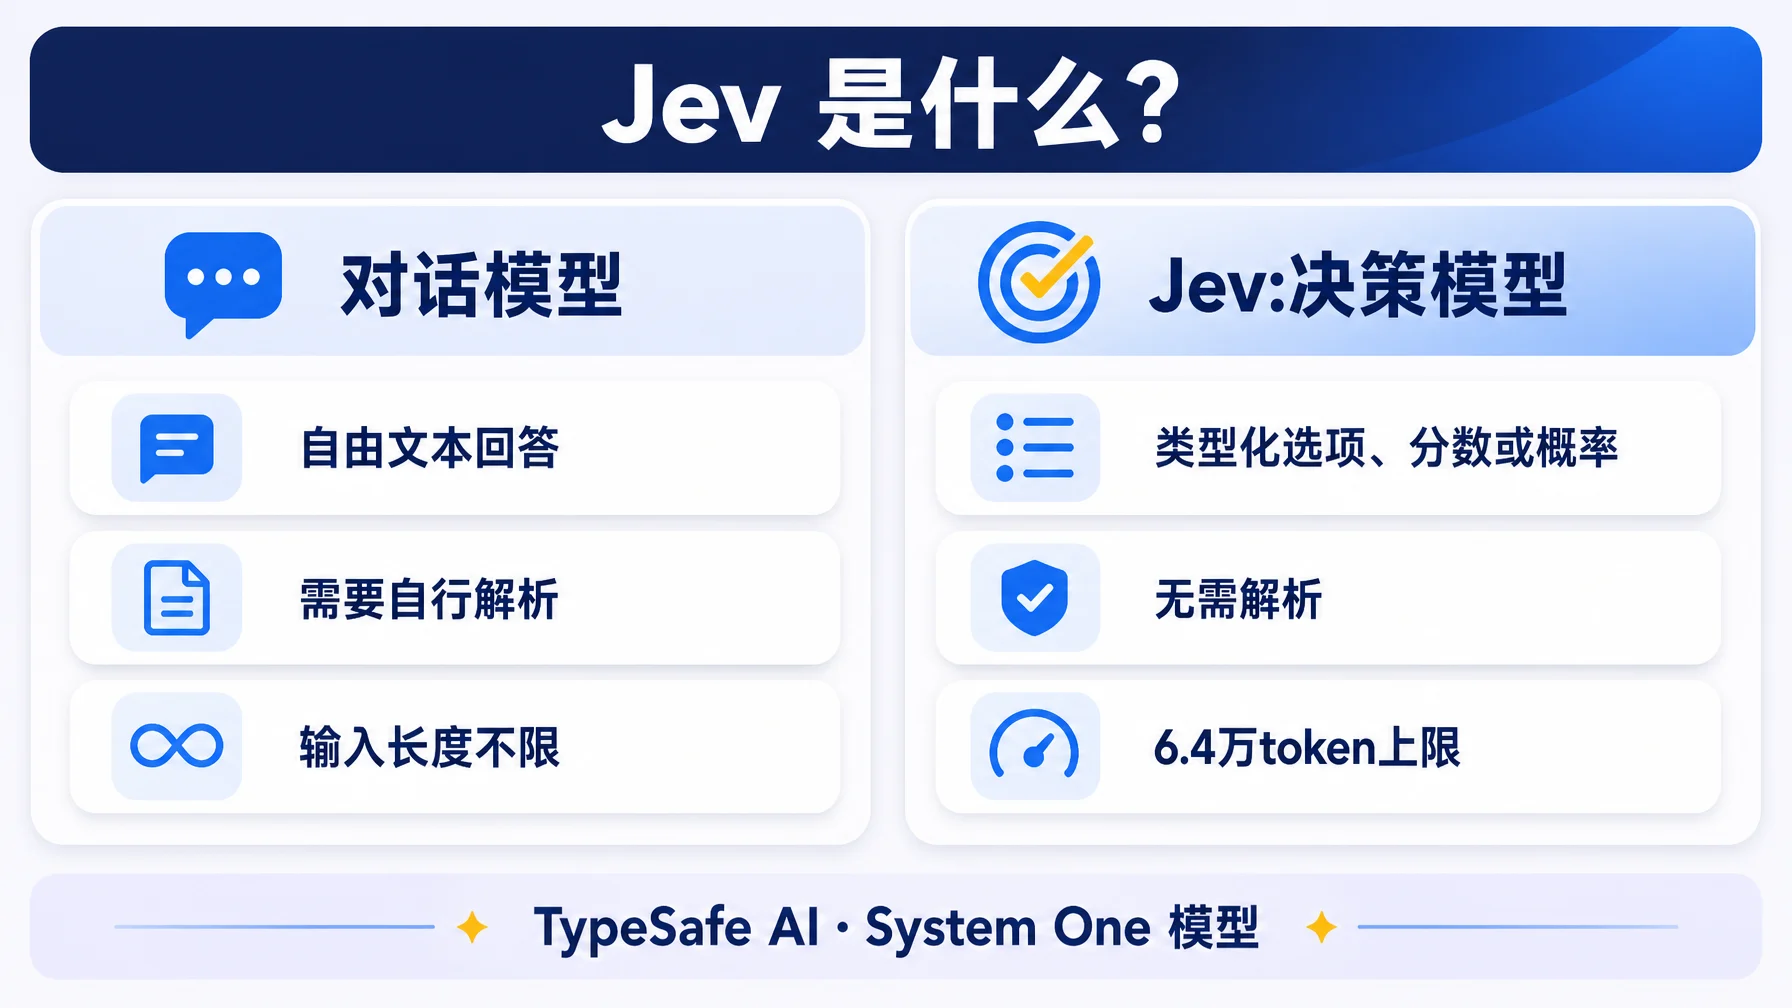
Jev 是类型化决策引擎,不是通用对话模型。它不接收自由格式的提示词并返回自由格式的文本,而是接收结构化的状态(state)(描述某种情境的文本)和一个问题(question),返回类型化的输出——一个决策、一个分数或一个概率——而不是一段文字。状态和问题合计上限为 32K token,整个交互的总预算为 64K token。它不像对话模型那样维护多轮对话历史;每次调用都是针对某个信息快照的独立判断。
可以这样理解两者的区别:对话模型回答"这里应该写什么?"Jev 回答"在这个确切情境下,决策是什么?"——它给出的是代码可以直接使用的值(分数、布尔值、排序后的选项),而不是需要解析的文本。
为什么它不符合 Glarity 的自定义模型设置
Glarity 的设置 → 通用 → 连接 AI 面板围绕一种形态构建:一个 OpenAI 兼容的 /chat/completions 端点,接收系统/用户消息数组并返回聊天补全结果。Glarity 通过"自定义模型"支持的所有模型——包括通过 API 密钥接入的第三方模型——都使用这个协议。
Jev 不是这样。它是类型化决策 API,不是聊天补全 API。它没有"系统提示词"或"对话"的概念可以映射到 Glarity 的翻译、总结或邮件回复功能上。这些功能的运作方式是把页面或视频内容作为聊天消息发送,然后取回文本回复——这不是 Jev 的输入输出契约所产生的形态。即使拥有有效凭证,也没有办法让 Glarity 的请求格式匹配 Jev 期望接收的格式。
如果你在评估 Jev,这意味着什么
如果你正在为某个实际场景评估 Jev——自动化审核决策、风险评分、结构化分诚——值得把它当作你自己掌控的流水线中的决策支持组件,按其本身的标准去评估,而不是当作浏览器扩展的对话后端。如果你真正想要的只是一个快速、实惠的模型来驱动 Glarity 的日常翻译和总结,那么通过 Glarity 自定义模型设置接入的标准聊天补全模型(Grok、Gemini 3.8 Flash 等)才是适合这项工作的工具。
常见问题
我能用 Jev 做 Glarity 的页面总结或翻译吗?不能。Jev 返回类型化的决策(分数、布尔值、概率),而不是这些功能所需的自由格式文本,而且它没有暴露供 Glarity 调用的聊天补全端点。
Jev 和大语言模型是同一类东西吗?它基于类似的底层技术构建,但暴露方式不同——面向决策的狭窄、结构化输入输出,而非开放式文本生成。
token 上限是多少?状态和问题合计上限为 32K token,整个交互的总预算为 64K token。
Glarity 里该用什么替代?任何 OpenAI 兼容的对话模型都可以——具体设置方法请参考 Glarity 现有的 Grok 或 Gemini 3.8 Flash 接入教程,通过自定义模型设置连接。
Glarity 编辑部专注于 AI 搜索、视频总结与浏览器效率技巧。