DeepSeek 现在最快的模型,同时也是最短命的。DeepSeek V4.1 Flash 于 2026 年 9 月 8 日以 deepseek-v4.1-flash-expires-on-0910 这个 ID 悄悄出现在 DeepSeek 的 API 里——一个把过期日期直接写进名字的内测版本。如果你已经在 Glarity 里用着 DeepSeek 的密钥,接入它只需改一个字段:密钥和 API 主机原封不动,在 Custom Model 里填入内测 ID 即可。不需要新端点、没有等候名单、也不用开新控制台,费率与 deepseek-v4-flash 完全相同。内测预计 9 月 10 日左右下线,想试的话,今天就是那一天。
DeepSeek 公开了什么(以及没公开什么)
9 月 8 日,DeepSeek 团队把这条内测消息发到了官方社区群,当天上午被转发到 Hacker News 的这段公告,就是目前全部的官方记录:
DeepSeek V4.1 Flash is now available for internal beta testing. It uses a new model architecture, with native multimodal support, stronger capabilities, faster speed, and lower cost. Keep thebase_urlunchanged and set the model name todeepseek-v4.1-flash-expires-on-0910to use it. Pricing is currently the same asdeepseek-v4-flash, with an account-level rate limit of 20 concurrent requests.
模型卡、技术报告、更新日志都还没有。截至今天,DeepSeek 官方模型与定价页上列着的仍然只有 deepseek-v4-flash、deepseek-v4-pro 和 deepseek-v4-flash-vision-exp 三个模型。所以下面的内容也请用 DeepSeek 自己的姿态来读:官方说法来自那段公告,速度数字来自首日开发者的实测,而这一切,都要靠你自己这两天的测试来验证。
事实速览
项目 | 值 |
|---|---|
模型 ID |
|
状态 | 内测——正式版之前的"中间版本"检查点 |
公开时间 | 2026 年 9 月 8 日,经 DeepSeek 官方社区群 |
到期 | 2026 年 9 月 10 日——ID 里写着,计划届时下线 |
架构 | 全新模型结构(官方表述),读起来是重新预训练而非训练后微调 |
多模态 | 基础模型原生支持图像+文本输入(8 月 21 日的 vision 模型是在文本模型上外挂视觉编码器) |
上下文窗口 | 未公布。没有任何数字,Glarity 的设置先保守填 |
费率 | 与 |
速率限制 | 每账户并发 20 个请求( |
运行位置 | DeepSeek 自家 API——base URL 与密钥都不变 |
四步接入
你需要的只是一个 DeepSeek 账户:在 platform.deepseek.com(DeepSeek 官方平台)新建或复用一个 API 密钥,用量直接计入该账户。
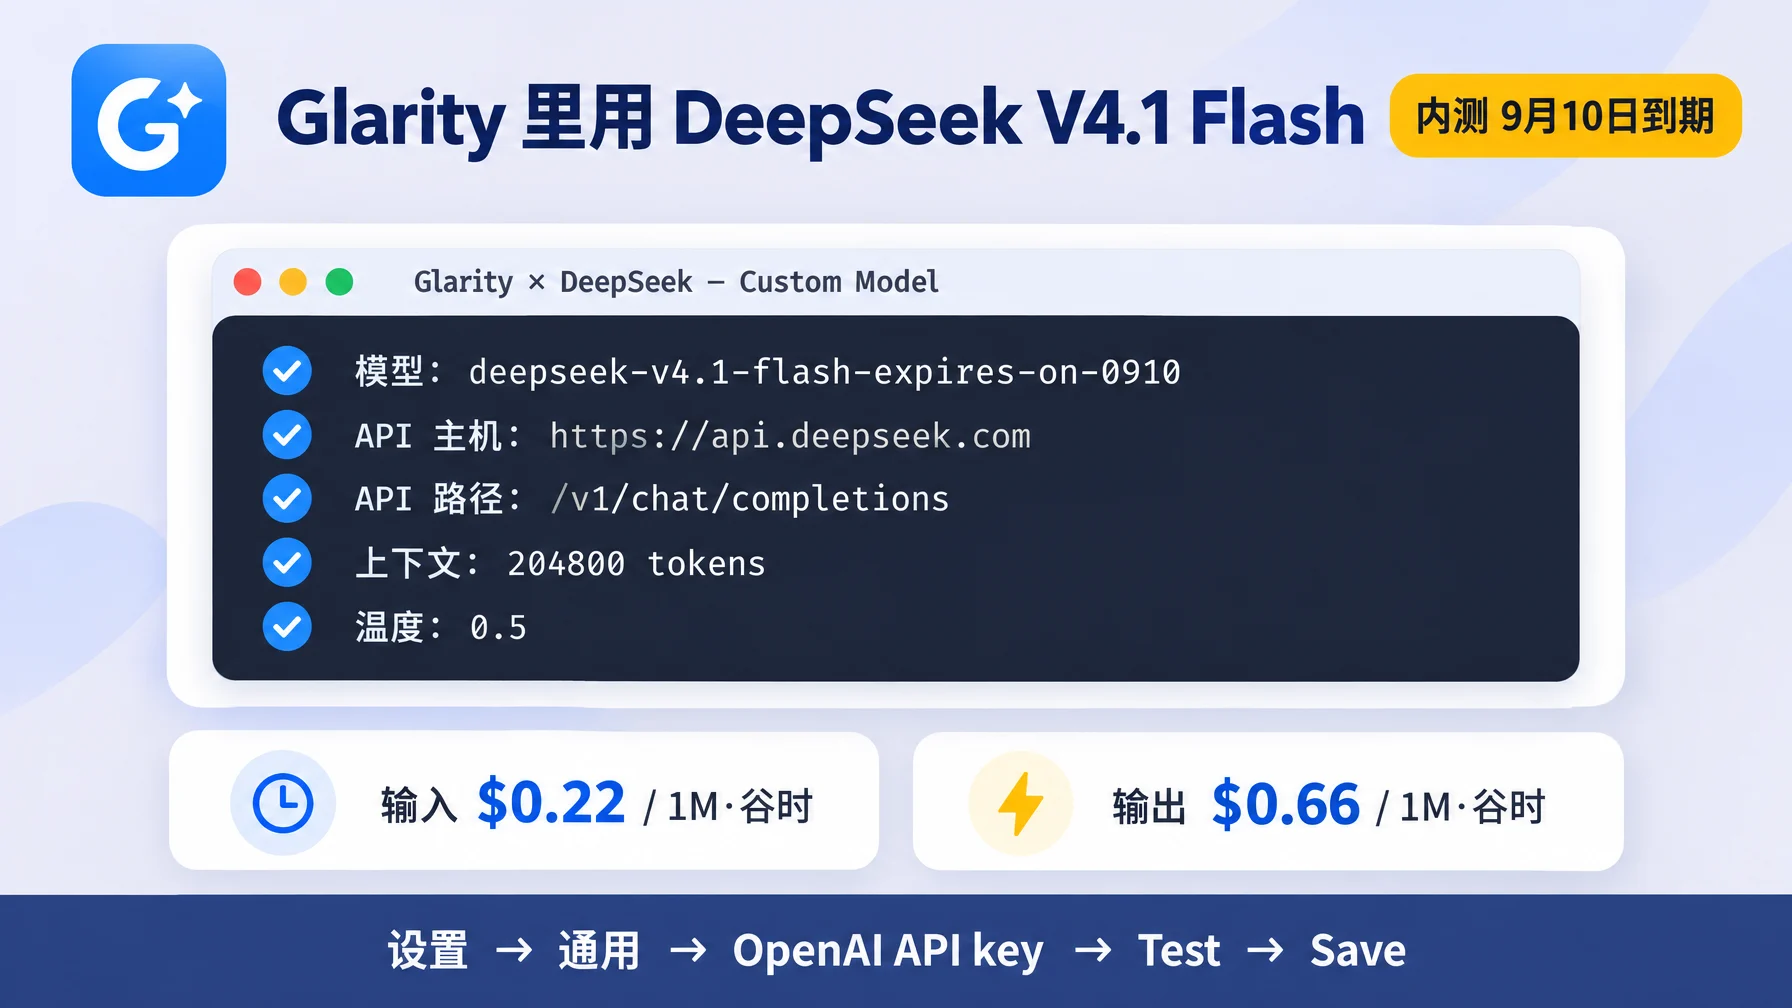
- 打开 Glarity → 设置 → 通用,滚动到 Connect to AI for quick Glarity summaries and translations,选择 "OpenAI API key"——也就是"支持任何 AI 厂商的自定义密钥"的那一项。
- 把 DeepSeek 的 API 密钥粘贴进 API Key 字段。
- Model——在下拉框选 Custom Model,一字不差地输入
deepseek-v4.1-flash-expires-on-0910,包括其中的两个点。这个 ID 不会出现在下拉列表里:它是隐藏内测,Hacker News 上的首日测试者也都得手动键入。 - 核对三个不用动的字段——API Host
https://api.deepseek.com、API Path/v1/chat/completions、Model Context Window204800tokens——Temperature 设为 0.5(要逐字直译就降到 0.2),点 Test 验证,再点 Save。
DeepSeek 明说"base_url 保持不变",所以这个内测有意复用了 deepseek-v4-flash 的全部接线。如果你已经按我们之前的 DeepSeek V4 Flash 设置指南配过,现在只需改第 3 步;之后想换回 deepseek-v4-flash,也还是同一个字段的事。
费用:直接套用 V4 Flash 费率表
内测按 DeepSeek 官方定价页上 deepseek-v4-flash 的现行费率计费。DeepSeek 自 2026 年 8 月 16 日起实行峰谷分时计价,其余时段按半价的谷时计(峰时:周一至周五 UTC 01:00–04:00 和 06:00–10:00)。
每 1M tokens | 谷时 | 峰时 |
|---|---|---|
输入(缓存命中) | $0.007 | $0.014 |
输入(缓存未命中) | $0.22 | $0.44 |
输出 | $0.66 | $1.32 |
换成 Glarity 的真实场景,按谷时估算:
任务 | 输入 tokens | 输出 tokens | V4.1 Flash(V4 Flash 费率) | 同样任务用 V4 Pro |
|---|---|---|---|---|
1 小时 YouTube 视频 → 总结+追问 | 约 12,000 | 约 1,000 | 约 $0.003 | 约 $0.010 |
30 页报告 → 全文总结 | 约 40,000 | 约 1,500 | 约 $0.010 | 约 $0.029 |
整本书的文档 → 分章笔记 | 约 200,000 | 约 3,000 | 约 $0.046 | 约 $0.138 |
充值之前先给你一个诚实的提醒:"更低成本"说的是效率,不是降价。token 单价没变,变的是模型生成快得多。首日就有测试者眼睁睁看着余额比在 V4 Flash 上同样几分钟掉得明显更快,因为这个内测烧 token 的速度更快。每个任务的真实成本是否真的下降,取决于它能否用更少的 token、更少的重试完成任务——而这正是你该亲手测量的东西。
今天值得测什么(以及首日传出的数字)
速度是主角,但目前流传的所有速度数据都来自社区实测。随内测一起被转发的那个研究者的 X 帖子测得平均解码速度约 350 token/秒;首日开发者报告长文本生成约 420 token/秒,峰值超 500,其中被广泛转发的一次测试在不到三分钟内生成了超过 71,000 个 token。作为参照,Artificial Analysis 测得公开的 DeepSeek V4 Flash 0731 端点约为 128 token/秒——照首日报告看,吞吐量的跃升至少 3 倍起步。与 8 月 21 日 vision 模型的同任务对比差距更大:SVG 代码生成任务约快 6 倍,49K token 长上下文检索约 5.2 倍,大型 SQL 生成优化任务约 5 倍。但这些都不是官方数字:它们是条件不受控的个人测量,DeepSeek 自己没发布任何速度基准,而且早期测试中最快的候选版本,未必就是最终发布的那一个。
质量方面没有任何公开基准。只有一个耐人寻味的细节:DeepSeek 附在内测里的反馈问卷直接问测试者,V4.1 Flash"能否完全替代线上的 DeepSeek V4 Pro"。这是 DeepSeek 自己向用户抛出的问题,不是对模型能力的官方断言——它是个悬而未决的问题,不是规格。
用你自己的 48 小时来测。在 Glarity 里,这个内测是低风险实验:总结一份一小时长的课程字幕,翻译一篇长文,追问几轮,然后用 deepseek-v4-flash 把同样的任务重跑一遍做对比。Glarity 的自定义连接发给模型的是页面和字幕的文本;V4.1 原生的图像输入要在直接调 API 并附带文件时才能用到,扩展的网页处理流程不走这条线。
依赖它之前,先记住这些
- 它会过期。ID 写着
expires-on-0910;从 9 月 8 日上线算起大约只有两天窗口,9 月 10 日左右计划下线。 - 每账户并发 20 个请求。一个人浏览足够;团队共享的工作流别指望它。
- 规格未公布。参数量、上下文长度、完整输入模态清单,一个都还没发布。
- 别接生产。谁都不该把固定工作流指着一个"计划停止响应"的模型 ID。内测归内测,日常仍用
deepseek-v4-flash。 - 正式版"很快"会来——知情者的预期和两天制的内测窗口都指向这一点,但尚未确认。正式版发布后,这套配置照旧适用:换个模型 ID(或下拉框里出现就直接选)。
连不上的时候
症状 | 可能原因 | 解决 |
|---|---|---|
Test 返回 401 | 密钥错误,或粘贴时带上了尾部空格 | 到 platform.deepseek.com 重新生成密钥,覆盖粘贴 |
"Model not found" / 模型不存在 | ID 打错了——或者内测已过期 | 一字不差输入 |
9 月 10 日前仍报同样错误 | 下拉列表里本来就不会有它——只能手输 | 按第 3 步,Custom Model + 手动键入 |
429 / 触发限流 | 每账户并发上限 20 | 等几秒;避免同时跑总结和翻译 |
Test 报连接错误 | 其他厂商的配置残留在主机或路径里 | API Host |
余额掉得比平时快得多 | 高 token 吞吐——只是快了 3 倍以上,单价没降 | 在谷时测试,并用"每个完成任务消耗的 token"对比 V4 Flash |
FAQ
DeepSeek V4.1 Flash 免费吗?不免费。内测按 deepseek-v4-flash 费率计费:谷时输入(缓存未命中)每 1M $0.22、输出每 1M $0.66,峰时翻倍。没有免费窗口期。
9 月 10 日之后内测还能用吗?按公告和 ID 本身的信息:不能——测试版预计届时自动过期下线。把模型字段改回 deepseek-v4-flash,等正式版发布。
需要新的 DeepSeek 账户或新密钥吗?不需要。它跑在同一个 API、同一把密钥、同一个平台账户上,变的只有模型名。
为什么 Glarity 的模型下拉框里找不到它?它是隐藏的内部测试,从未进入任何公开模型列表。Custom Model 加手动键入完整 ID,是唯一的入口。
日常的 Glarity 使用应该切到它吗?不适合当日常主力。用这两天窗口去对比质量与每个任务的真实成本就够了;有 20 并发限制,又自带过期时间,它是测试用,不是日用款。
V4.1 Flash 能在 Glarity 扩展里读图吗? DeepSeek 称其原生支持图像+文本输入,所以直接调 API 并附带文件时可以。但 Glarity 的自定义模型连接总结和翻译的是网页与字幕的文本;想试视觉能力,请直接调用 API 并附上图片文件。
怎么换回稳定的 DeepSeek 模型?只改一个字段:把 Model 改回 deepseek-v4-flash,密钥、主机、路径全部不动。端点、温度、上下文窗口照常有效。
Glarity 编辑部。Glarity 编辑部专注于 AI 搜索、视频总结与浏览器效率技巧。
Glarity 是一款免费的浏览器扩展,支持 AI 搜索与 YouTube 视频总结,可在 glarity.app 获取。